写在前面:这一章是 L2 主课的「营养加餐」,不是必读内容。
主线是 L2-07 到 L2-12,但如果你对“AI 怎么影响人脑”或“AI 系统怎样安全完成工作”感兴趣,这里还准备了两篇研究导读和一套 L2 原创图文微课。学习建议:论文按兴趣选读;原创图文微课从基础到工程共 30 讲,可以按模块学习。
1. 这一章是什么
L2 主课讲的是 "怎么用 AI 把你的工作流跑起来"——做 Agent、做 Skill、做知识库。
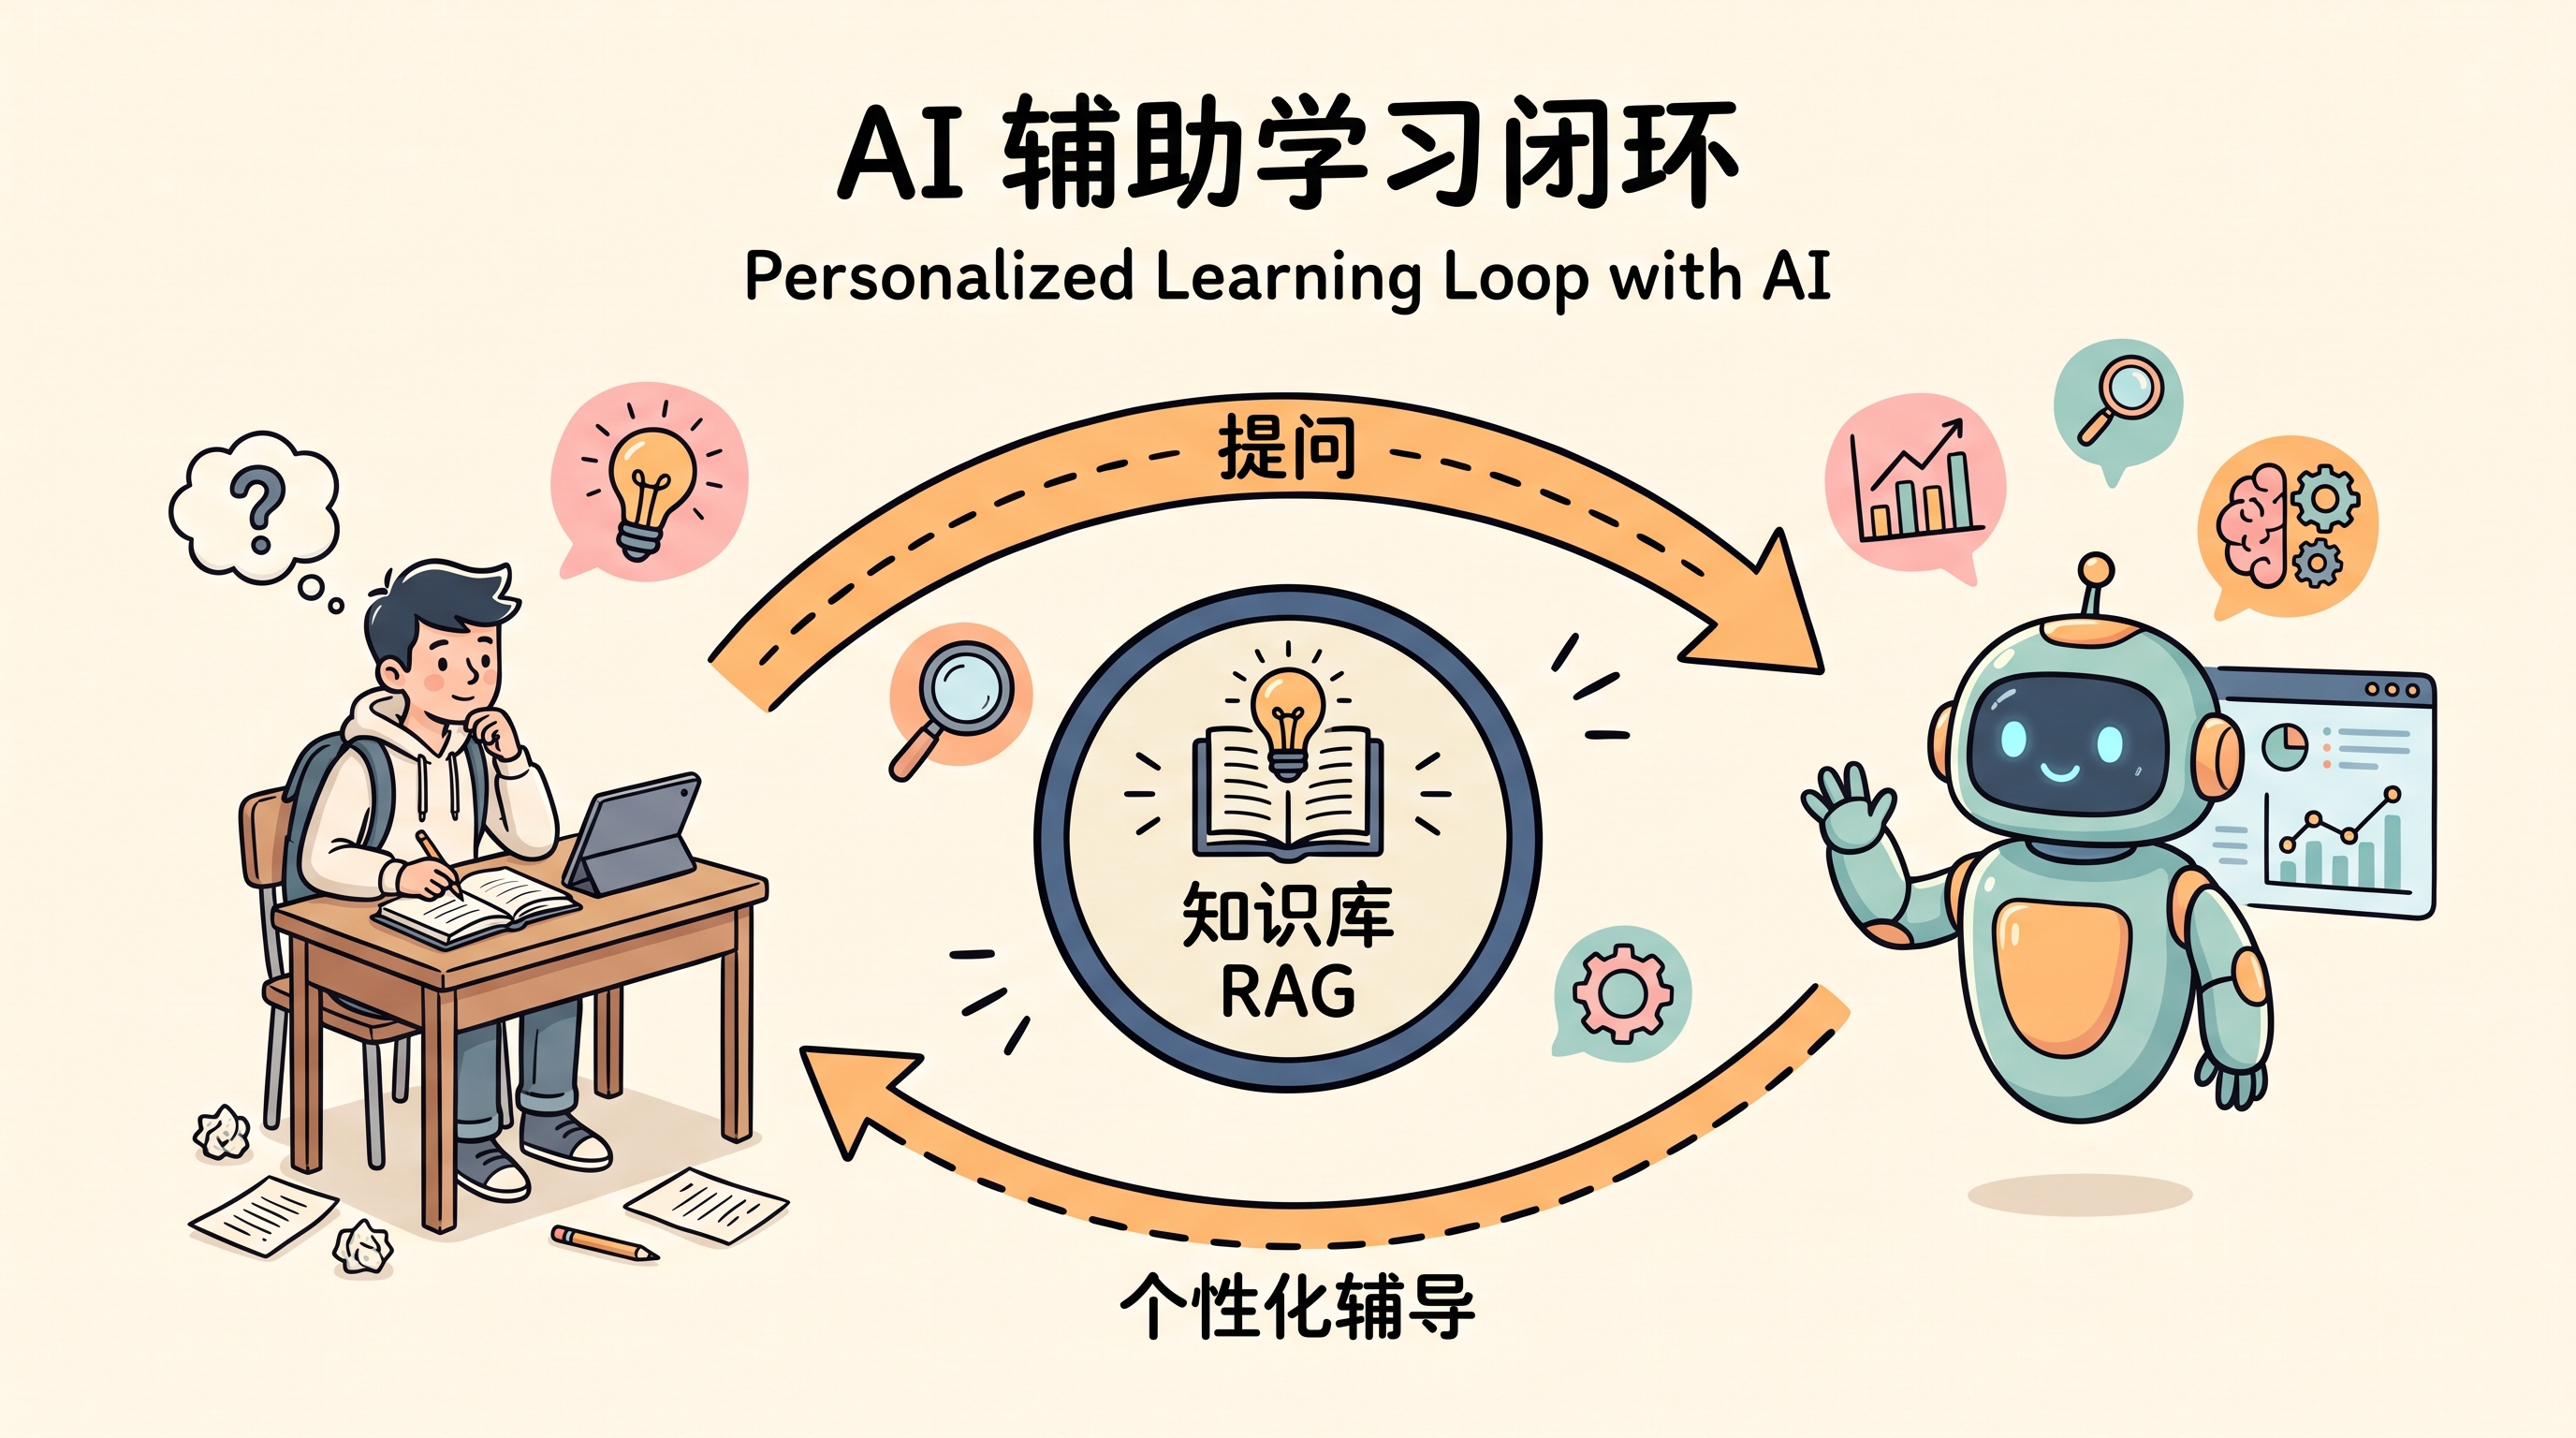
衍生学习这一章换一个角度,看 "AI 怎么改变人是怎么学的":
- 2 篇学术论文:讲最新的研究发现,AI 时代人的认知会发生什么变化。
- 1 套 L2 原创图文微课(30 讲):把基础原理、Agent 工程和当前热点重新组织成自己的课程。
看完之后你会得到 3 件事:
- 看懂学术黑话:下次看到"认知外包""知识追踪"这种词不再懵。
- 理解 AI 时代的教育趋势:为什么 L2 主课反复强调"AI 是助手不是替代"。
- 反思自己的学习方式:怎么用 AI 让自己学得更好,而不是变懒。
2. 学术论文:2 篇精选
论文 1:认知外包——把脑子记不住的事交给工具
| 项目 | 信息 |
|---|---|
| 标题 | Meta-cognitive insights into cognitive offloading: mechanisms, interventions, and educational implications |
| 作者 | Yufei Guo, Qun Ye(郭宇飞、叶群) |
| 期刊 | Humanities and Social Sciences Communications(Nature 子刊) |
| 发表日期 | 2026-03-21 |
| DOI | 10.1057/s41599-026-06621-5 |
| 类型 | 综述论文(Review) |
| 主题 | 教育、心理学 |
一句话总结
认知外包(Cognitive Offloading)= 人类把自己记不住、想不清楚的事,交给外部工具(笔记本、计算器、搜索、AI)去做的过程。这篇综述讲清楚了三件事:为什么我们这么爱外包、外包之后脑子会发生什么、教育领域该怎么办。
为什么要看这篇
- 它是 L2 主课的"理论支柱":L2-07 讲"工作流拆解"、L2-08 讲"知识库",本质上都是在做"认知外包"——把脑子不想干的活,交给 AI 去干。看完这篇论文,你就知道这种做法的科学依据是什么。
- 解释了为什么 AI 是"放大器"不是"替代者":外包做得太狠,自己的能力会变弱(手机号都记不住就是典型例子)。但做得太保守,又会被时代甩开。论文给了教育界一个"怎么教孩子适度外包"的框架。
- 原创图文微课第 08 讲“怎样健康地把脑力工作交给 AI”与这篇论文主题相连,可以配套学习。
3 个关键概念
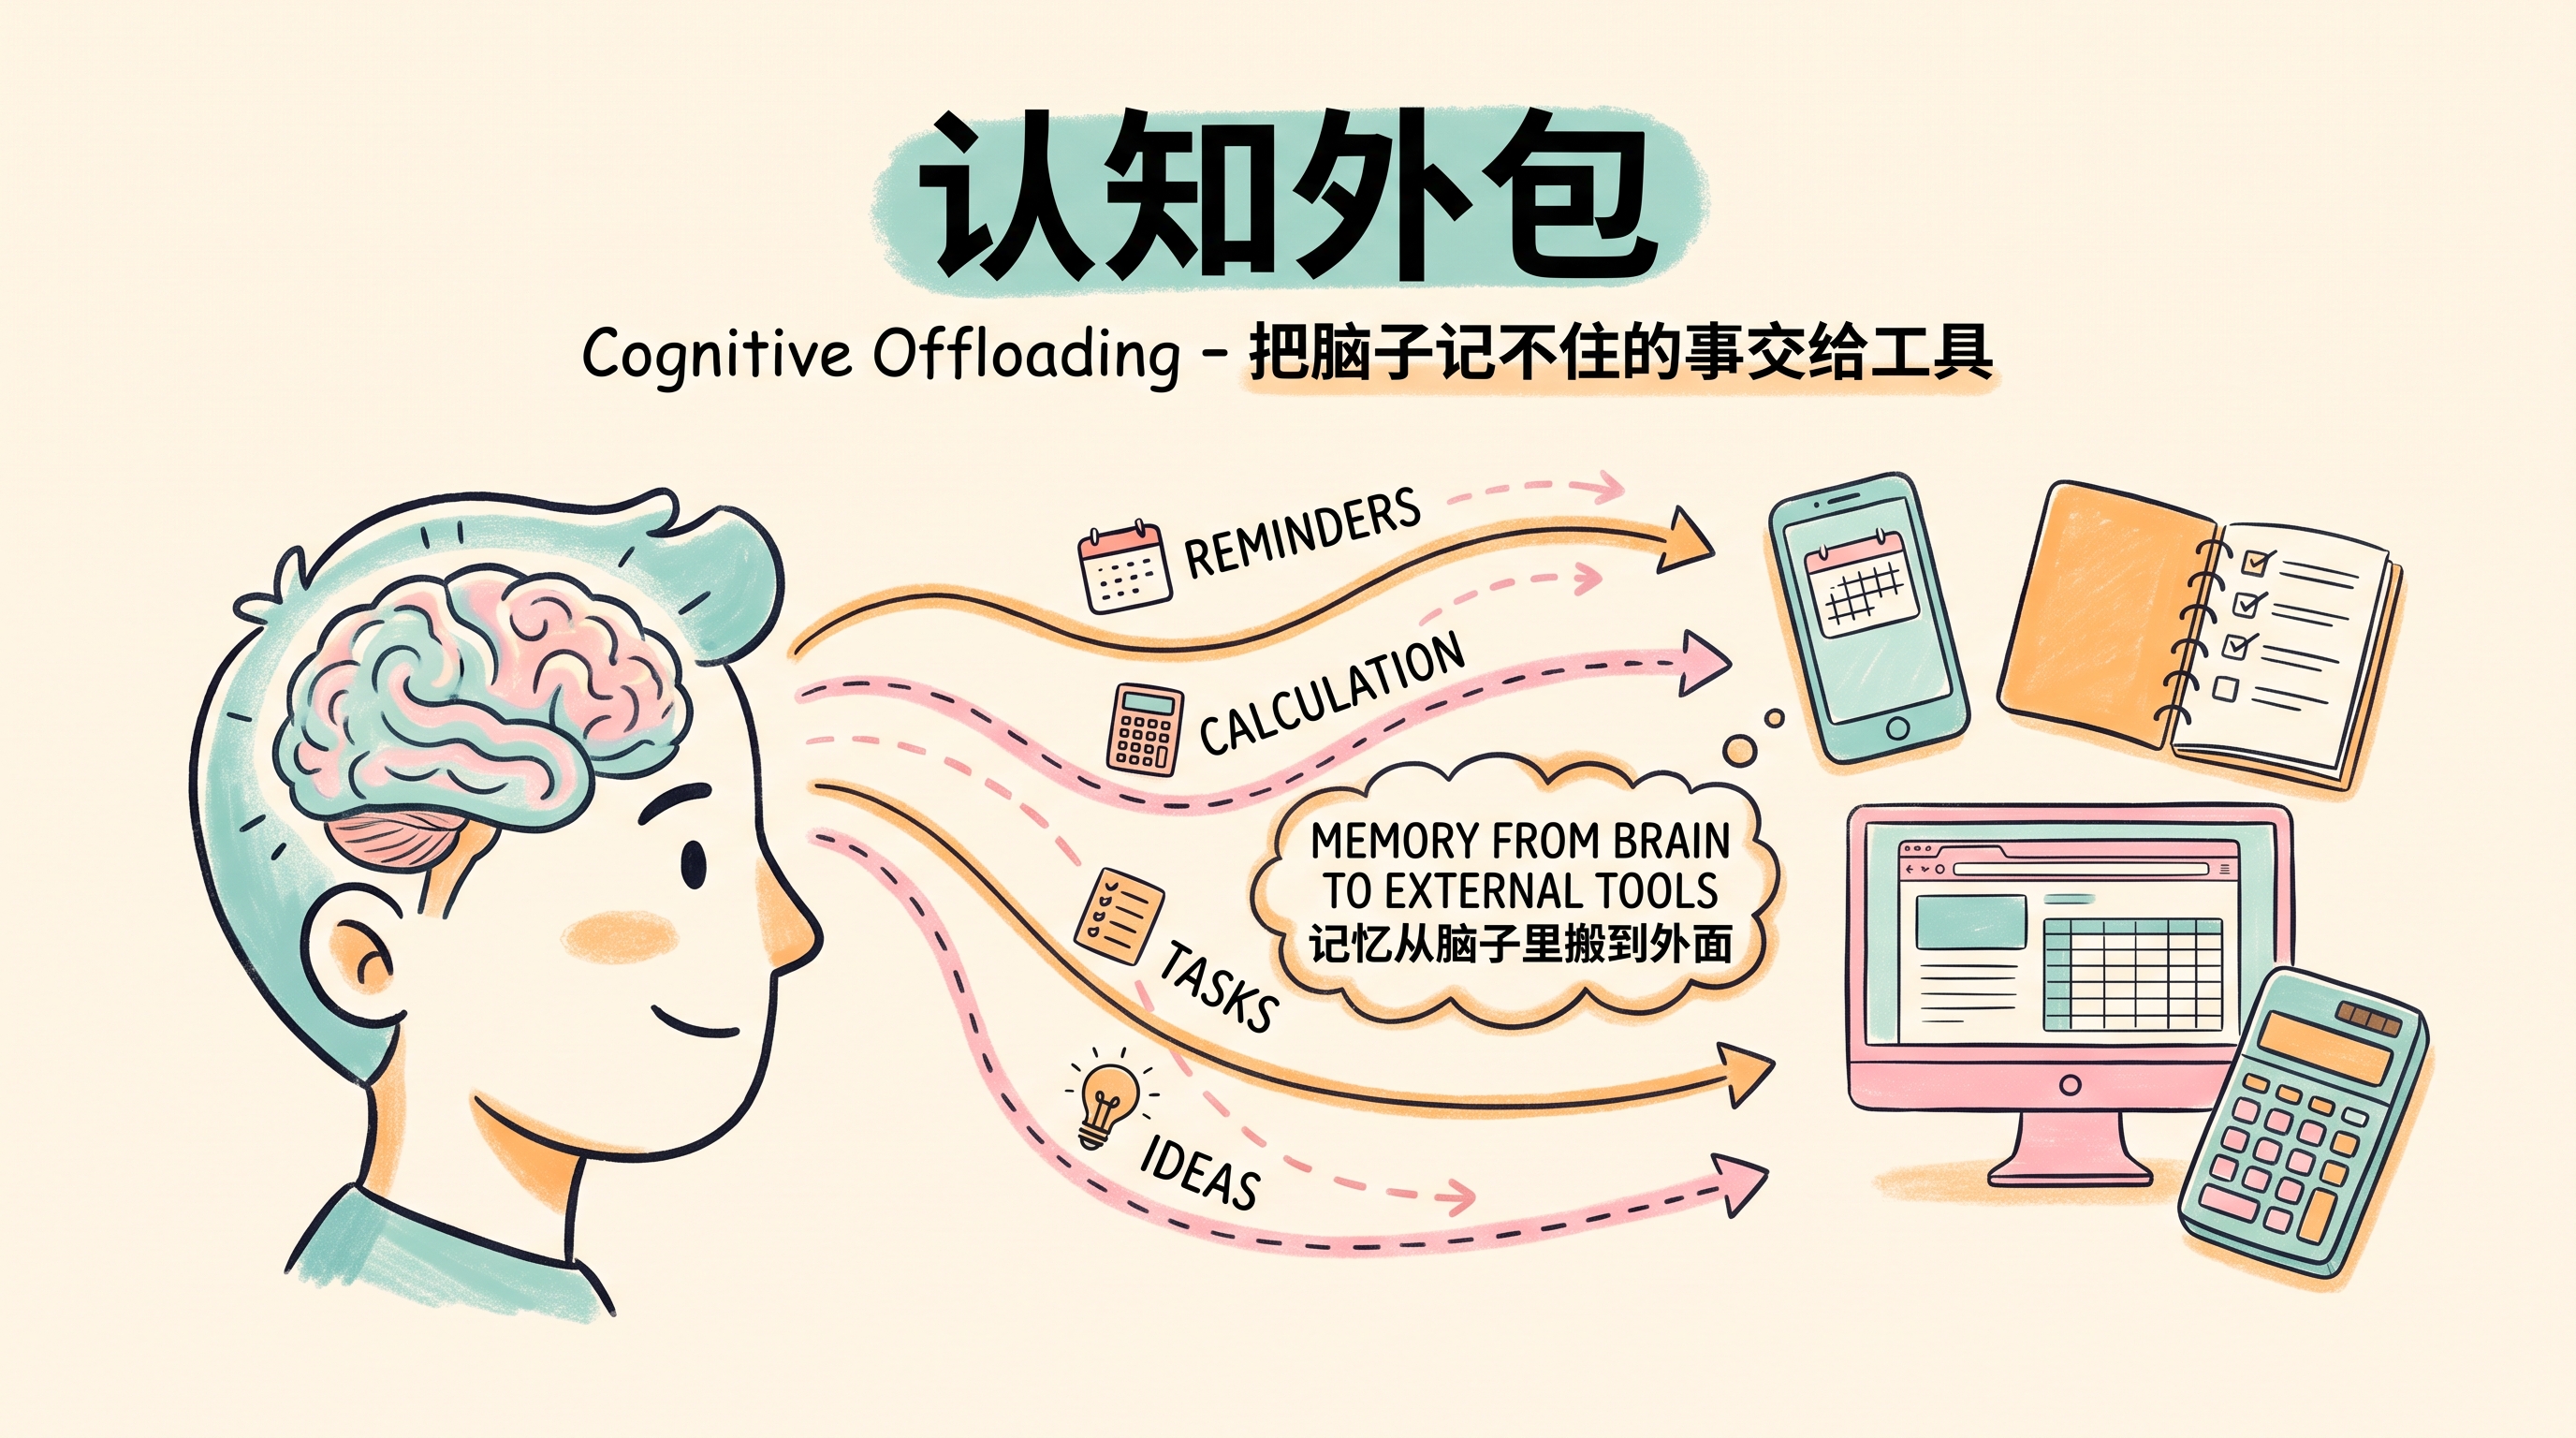
1. 什么是认知外包(What)
你拿计算器算 123 × 456,不是你算得慢,是你把"算"这件事外包给了一个工具。
你用 Google 查一个词的意思,不是你没文化,是把"记忆"外包给了一个搜索引擎。
你让 ChatGPT 帮你写周报,不是你不会写,是把"组织语言"外包给了一个语言模型。
2. 元认知(Meta-cognition)——外包的"开关"
元认知 = "对自己认知过程的认知",通俗说就是"我知道我自己懂不懂、记不记得"。
论文的关键发现:能不能适度外包,取决于元认知水平。
- 元认知强的人:该外包的(自己算到头秃)外包出去,自己只做最有价值的事。
- 元认知弱的人:要么啥都外包(自己变空壳),要么啥都不外包(累死自己)。
3. 教育启示——怎么"教"外包
学校应该教的不是"不能查手机",而是"什么时候该查、查完要消化成自己的"。
这对 L2 主课的启示是:AI 不是"用了就赢、没用就输",而是"用了 + 内化 = 赢"。
5 条核心 takeaway
- 认知外包是人类的本能——几万年前人类就在用绳子打结记事、用手指比划算数了,AI 只是最新的外包对象。
- 外包 ≠ 偷懒——关键看你是"外包 + 消化"还是"外包 + 抛弃"。前者越用越强,后者越用越空。
- 元认知是开关——定期问自己"我刚才让 AI 干了啥、这件事我自己还会做吗",是健康外包的核心习惯。
- AI 时代的教育不是"禁手机"——而是教"什么时候用、怎么用、用完怎么内化"。
- 跟 L2 主课的关系:L2-07 / L2-08 / L2-10 学的所有内容(Agent、Skill、知识库),本质都是"把脑子不想干的活外包给 AI"——主课在教工具,这篇论文在讲底层原理。
阅读建议
- 先看图文课再看论文:先学原创课程第 08 讲,用生活比喻建立直觉,再用论文术语加深理解。
- 重点看摘要 + 结论:正文很长,摘要(Abstract)和结论(Conclusion)把核心观点都说完了。
- 挑感兴趣的章节深读:论文分了"机制 / 干预 / 教育启示"三块,挑你工作最相关的那块。
论文 2:深度知识追踪——AI 怎么知道你会什么、不会什么
| 项目 | 信息 |
|---|---|
| 标题 | Deep knowledge tracing and cognitive load estimation for personalized learning path generation using neural network architecture |
| 作者 | Chunyan Tong, Changhong Ren(童春燕、任昌宏) |
| 期刊 | Scientific Reports(Nature 子刊) |
| 发表日期 | 2025-07-10 |
| DOI | 10.1038/s41598-025-10497-x |
| 类型 | 研究论文(Research Article) |
| 主题 | 计算机科学、教育心理学 |
一句话总结
深度知识追踪(Deep Knowledge Tracing,DKT)= 用神经网络模型,看一个学生做过的题,就能预测他下一个题会不会做、对哪块知识还模糊。论文还加入"认知负荷"(Cognitive Load)这个维度,让推荐的学习路径更贴合学生脑子能不能装得下。
为什么要看这篇
- L2-08 知识库和 RAG 的"教学版":L2 教的是怎么用 RAG 帮 AI 找答案;这篇论文是 RAG 思路反过来用在"人"身上——AI 看你的答题历史,就能精准推荐下一题学什么。
- 解释了"自适应学习"是怎么实现的:你用过可汗学院、猿辅导、Duolingo 吗?它们背后用的就是知识追踪模型。看完这篇你就能跟人讲清楚"为什么这个 App 推的题总是刚刚好"。
- L2-09 Agent 的隐藏能力:如果你的 Agent 知道用户当下的认知负荷(是累了还是轻松),它就能"见机行事"——用户累就推简单题,状态好就推难题。这篇论文给了方法。
3 个关键概念
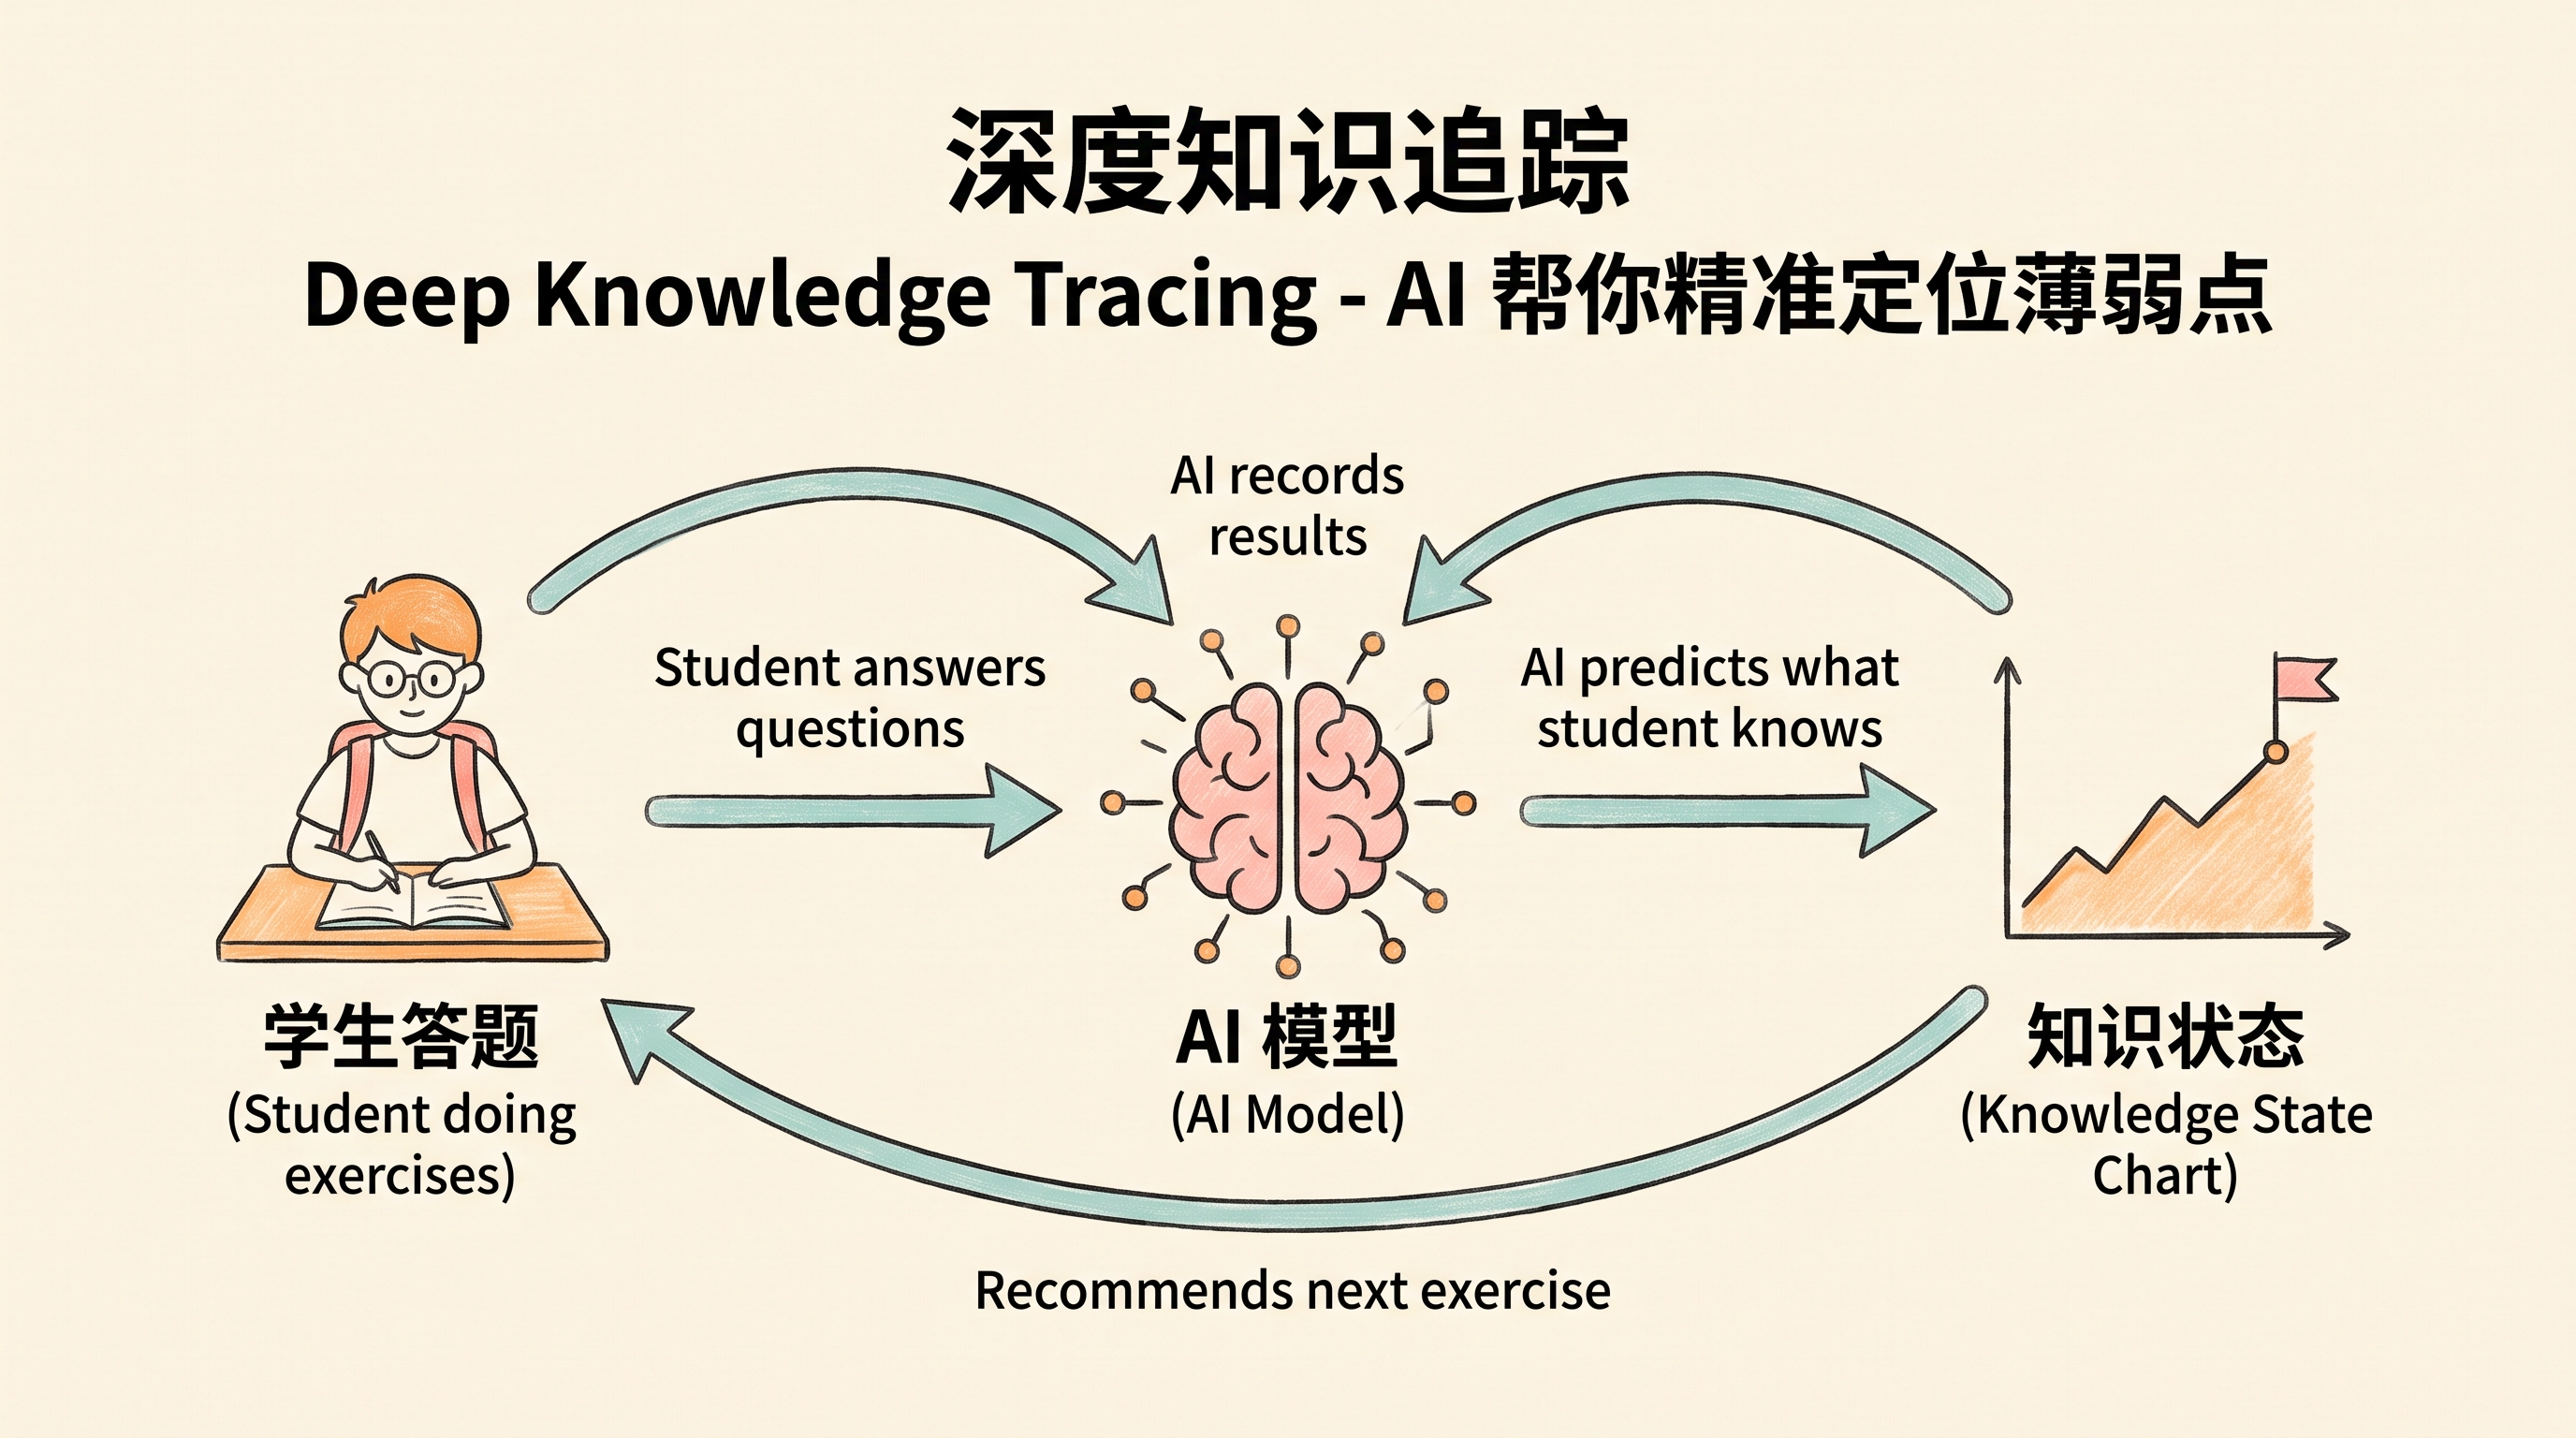
1. 知识追踪(Knowledge Tracing,KT)——AI 版的"错题本"
传统错题本:你做错了什么题,抄在错题本上,过几天复习。
知识追踪:AI 看你的答题历史(不只是错题,对题也看),用一个数学模型(RNN、LSTM、Transformer)算出来一个"知识状态向量"——这个向量表示你对每个知识点的掌握程度。
公式简化:
下一题做对概率 = f(历史答题序列)
听起来玄乎,本质就是"AI 在心里给你画了一张知识点雷达图"。
2. 认知负荷估计(Cognitive Load Estimation)——AI 版的"测心率"
认知负荷 = 你大脑当下"装了多少东西"。新东西装多了,脑子会卡。
论文用学习者的行为数据(停留时间、答题速度、反复回看次数)来估计认知负荷,避免推"装不下"的难题。
3. 个性化学习路径生成(Personalized Learning Path)——AI 版的"私教"
知道你会什么、知道你现在累不累,就能排出一张"今天最适合你学的内容"清单。
跟 L2 主课的对应:这就是一个"为学生而生的 Agent"。
5 条核心 takeaway
- 深度知识追踪 ≠ 单纯统计错题——它用神经网络看答题序列(你答题的顺序、节奏、模式),能推断出你不知道自己不知道的盲区。
- 认知负荷很关键——一个劲儿推难题的学生会"学崩",一个劲儿推简单题的学生会"无聊死"。AI 需要学会看人脸色(行为数据)。
- 个性化 ≠ 随机刷题——是按知识点的依赖关系排路径(先学 A 再学 B 因为 A 是 B 的基础),不是乱推。
- 对 L2 的启示:你的 Agent 不应该只接需求,还应该"理解用户当下的状态"——用户累不累、急不急、懂不懂。比 L2-09 的"四要素"多一个维度:状态感知。
- 对个人的启示:可以用类似思路管理自己学习——每周末回顾"这周我学啥、卡在哪、要不要换条路",这本身就是一种"对自己的知识追踪"。
阅读建议
- 方法部分可以跳过——论文里有一大堆神经网络架构图(DKT、SAINT、AKT 等),不是 AI 方向的同学看着会懵,跳过不影响理解核心思想。
- 重点看图 1 和图 2——这两张图把"输入—模型—输出"画得非常清楚。
- 跟论文 1 配套看——论文 1 讲"为什么人会想外包脑子里的事",论文 2 讲"AI 怎么帮人高效学",一对姐妹篇。
3. L2 原创图文微课:AI 核心概念与 Agent 工程 30 讲
原来的外部视频选集已经改为 L2 自有课程。课程重新设计了知识顺序、生活比喻、工作案例、练习和配图,不要求学员观看、复述或模仿任何第三方视频。
| 模块 | 对应课程 | 学完能说明什么 |
|---|---|---|
| AI 基础 | 第 01—04 讲 | AI、生成式 AI、大语言模型和推理模型怎样工作 |
| Agent 与人 | 第 05—11 讲 | Agent、具身智能、对齐、认知外包、工作变化与世界模型 |
| 知识与连接 | 第 12—16 讲 | RAG、提示词、Skill、MCP 与 Agent 的区别和关系 |
| 工程热点 | 第 17—20 讲 | OpenClaw、Hermes Agent、二者区别及长任务安全护栏 |
| 技术原理加深 | 第 21—30 讲 | 机器学习、Token、神经网络、Transformer、训练与微调、扩散生图和 AI 编程 |
学习方式:每讲按照“先看图 → 听懂大白话 → 看工作例子 → 做一个小练习”的顺序学习。后续短视频脚本和口播稿将从这份原创图文母稿拆分,而不是从第三方视频字幕改写。
4. 怎么把这一章和 L2 主线连起来
很多学员会担心"这些论文和视频跟主课无关"。其实强相关——下面这张表是 L2 主课章节和本章资源的对应:
| L2 主课章节 | 核心问题 | 对应论文 | 对应原创微课 |
|---|---|---|---|
| L2 AI 入门科普 | AI 到底是什么? | 论文 1 部分相关 | 第 01—04 讲 |
| L2-07 工作流拆解 | 什么活适合让 AI 干? | 论文 1(元认知判断) | 第 08、09 讲 |
| L2-08 知识库 | AI 怎么"记得"我的资料? | 论文 2(知识追踪) | 第 03、12 讲 |
| L2-09 打造 Agent | Agent 是怎么自己干活的? | 论文 2(个性化路径) | 第 04、05、16 讲 |
| L2-10 制作 Skill | 怎么让 AI 不出错? | 论文 1(健康外包) | 第 07、14、15、20 讲 |
| L2-11 收官 | AI 时代怎么和人协作? | 论文 1(元认知习惯) | 第 07—10、20 讲 |
| L2-12 延伸 | AI 会怎么影响行业? | — | 第 06、09、11、17—20 讲 |
| L2 市场分析 | 怎么看待 AI 时代? | — | 第 09、10 讲 |
学习路径建议
路径 A:只想加深的(1 周)
- 学第 08 讲(认知外包)→ 读论文 1 摘要 + 结论
- 学第 05 讲(Agent)→ 读论文 2 的图 1 和图 2
- 选学第 12—16 讲,理解 RAG、提示词、Skill、MCP 与 Agent
- 回到 L2 主课,重新看一遍 L2-07 / L2-09 / L2-11
路径 B:想完整看完的(2 周)
- 第 1-2 天:学习第 01—04 讲,建立 AI 基础
- 第 3-4 天:读论文 1(重点摘要 + 结论 + 概念图)
- 第 5-6 天:学习第 05—11 讲,理解 Agent 与人的关系
- 第 7-8 天:学习第 12—16 讲,理解知识、连接与执行
- 第 9-10 天:学习第 17—20 讲,理解 OpenClaw、Hermes 与工程安全
- 第 11-14 天:回看 L2 主课相关章节,写自己的"AI 学习反思笔记"
路径 C:只想看 3 个最值得看的
- 第 08 讲:健康的认知外包
- 第 16 讲:提示词、Skill、MCP 与 Agent 的关系
- 第 20 讲:长任务的安全护栏
5. 5 个思考题(自测掌握程度)
看完本章之后,试着回答这 5 个问题。答得上来就算掌握:
- 认知外包的反义词是什么?为什么我们不能"完全不外包"?
- 元认知强的人和元认知弱的人用 AI 有什么不同?
- 知识追踪模型需要什么数据才能给你推下一题?(提示:不是"做错的题"就够了)
- 推理模型和普通大模型的本质区别是什么?举一个适合用推理模型的场景。
- 以人为中心的 AI(HCAI) 的核心是"AI 越强越好"还是"AI 越合适越好"?为什么?
📝 答案参考(先自己想再看)
1. 反义词是"内化"(internalize)或"独立完成"。我们不能不外包,因为人脑容量有限(短时记忆 7±2 项),全靠自己记会爆。 2. 元认知强的人会"挑活外包"——把无聊重复的活外包,自己留最有价值的事;元认知弱的人要么全外包要么全不外包。 3. 需要"完整的答题历史"——包括对题、错题、答题时间、反复回看的次数。不只是"错题本",是"学习行为时序数据"。 4. 本质区别是"会不会先在内部模拟一遍再输出"。推理模型适合数学证明、规划、复杂决策;普通模型适合聊天、写作、翻译。 5. "AI 越合适越好"。HCAI 强调 AI 是为人服务的工具,越强不代表越好,关键是"对人有益、对人尊重"。6. 资源汇总
📄 论文
- Guo, Y. & Ye, Q. (2026). Meta-cognitive insights into cognitive offloading: mechanisms, interventions, and educational implications. Humanities and Social Sciences Communications. DOI: 10.1057/s41599-026-06621-5
- Tong, C. & Ren, C. (2025). Deep knowledge tracing and cognitive load estimation for personalized learning path generation using neural network architecture. Scientific Reports. DOI: 10.1038/s41598-025-10497-x
🎬 视频
- B 站频道:BV1Pyamz6ETN —— UP 主:王先生的思维图
- 完整 23 集,本章精选 11 集讲解
- 配套工具包:关注微信公众号「秀儿科技资源分享社」
🖼️ 本章配图
| 图编号 | 名称 | 说明 |
|---|---|---|
| 23 | 认知外包概念 | 把脑子记不住的事搬到外部工具 |
| 24 | 知识追踪闭环 | AI 看你的答题数据 → 预测你会什么 → 推下一题 |
| 25 | AI 辅助学习闭环 | AI 辅助学习,让 AI 帮你"学得更好"而不是"代替你学" |
7. 写在最后
这一章是 L2 主课的"长尾"——主课教你"怎么用 AI 干活",这一章告诉你"AI 怎么改变人"。
- 如果你只想学技术:看完 L2-07 到 L2-12 就行,这一章可以跳过。
- 如果你想理解趋势:强烈建议至少看 P13 / P10 / P14 三集,5 分钟就能装一肚子和同行聊天的"黑话"。
- 如果你对教育 / 心理学 / AI 哲学感兴趣:两篇论文 + 全部 11 集值得一刷。
最后一句话:AI 时代最值钱的不是"会 AI 的人",而是"会用 AI 还能保持自己思考能力的人"——这一章就是帮你保持思考能力的。